
AI大模型是目前最火的技术,下面我详解AI大模型技术@mikechen
AI大模型
所谓“大模型”,通常指参数规模巨大、训练数据海量、具备较强通用能力的深度学习模型。

以大语言模型为例,它的核心任务可以概括为:将输入文本转换为概率分布,再逐个预测下一个 Token。
模型不直接认识“字”或“词”,而是先把输入切分成 Token。
比如:Token 可以是一个汉字、词的一部分、完整英文单词、标点、代码符号等。
输入:Java 线程池如何避免任务堆积?
       ↓ Tokenizer
Token:["Java", "线程", "池", "如何", "避免", "任务", "堆积", "?"]
       ↓ Token ID
ID:   [15342, 28901, 7712,  ...]
所以,Token:是模型处理的基本单位。
以语言大模型为例,其训练目标:通常是预测下一个词或补全缺失内容。
模型在大量文本中学习语言规律、语义关联和知识模式,从而在生成阶段输出连贯、合理的文本。
AI大模型架构
Transformer 是当前大模型最重要的基础架构,其最大优势在于并行计算能力强、建模长依赖效果好。
现代大语言模型大多建立在: Transformer 之上。
大模型的架构通常可以分为四层:输入层、编码/表示层、核心计算层和输出层。
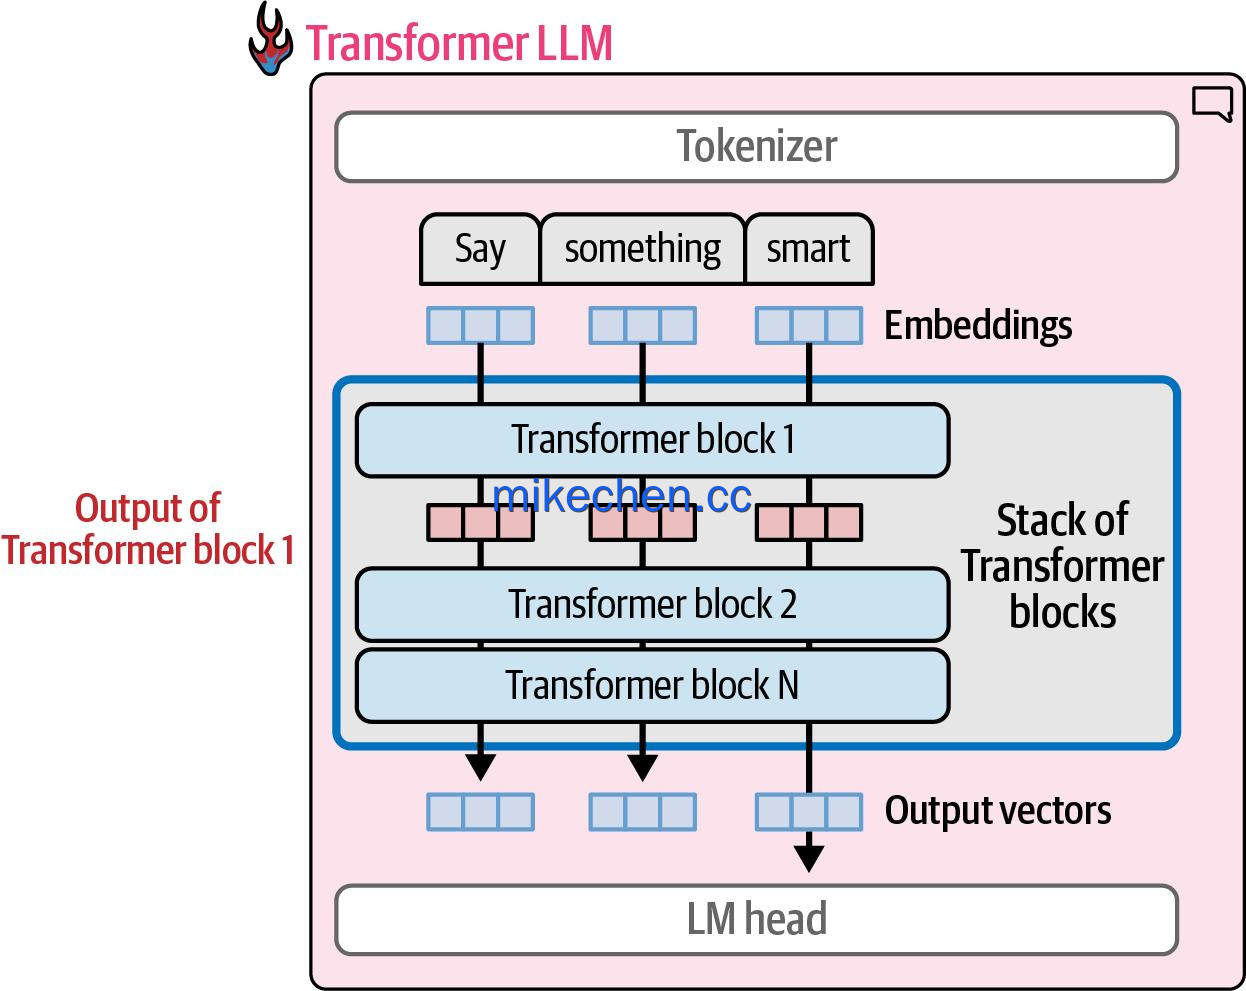
1. 输入层
输入层负责接收文本、图像、音频或视频等数据,并进行标准化处理。例如文本会被切分为 token,图像会被转换为 patch 或特征向量。
2. 表示学习层
该层的作用是将原始数据映射到高维向量空间,使模型能够捕捉数据中的语义关系。
对于语言模型而言,这通常包括词嵌入、位置编码等机制。
3. 核心计算层
这是大模型的主体,通常由多层 Transformer Block 叠加而成。
每一层包含注意力机制和前馈神经网络,用于提取上下文信息、建模长距离依赖,并逐层抽象特征。
4. 输出层
输出层根据任务类型生成预测结果。
例如语言生成任务输出下一个 token 的概率分布,分类任务输出类别概率,多模态任务则可能输出文本、标签或结构化结果。
AI大模型核心技术
大模型的实现通常包括数据准备、模型设计、预训练、微调与部署五个阶段。

1. 数据准备
高质量数据是大模型性能的基础。
训练数据通常来源于网页、书籍、论文、代码库、对话语料等。
数据处理环节包括清洗、去重、分词、标注与格式统一。
若数据质量不足,即使模型规模很大,也可能产生错误知识或偏差输出。
2. 模型设计
在实现层面,需要根据任务目标确定模型结构、参数量、层数、隐藏维度与注意力头数等超参数。
同时,还要考虑训练效率、显存占用与推理速度。对于超大模型,往往需要采用分布式训练、模型并行和数据并行等技术。
3. 预训练
预训练:是大模型能力形成的关键阶段。
模型在通用语料上进行大规模自监督学习,掌握基础语言规律和知识表示能力。
由于预训练成本极高,通常需要依赖GPU集群、混合精度训练和高效优化器,如AdamW等。
4. 微调与对齐
预训练模型虽然具备通用能力,但未必适合具体业务场景。
因此,需要通过监督微调、指令微调或强化学习等方式,使模型更符合人类意图和任务需求。
近年来,“对齐”成为重要方向,即让模型输出更安全、更有用、更符合价值规范。
5. 部署与推理
模型训练完成后,还需部署到生产环境中。
推理阶段要重点关注响应速度、资源消耗和并发能力。
常见优化方法包括量化、剪枝、蒸馏、KV缓存与推理加速框架等,以降低部署成本并提升用户体验。